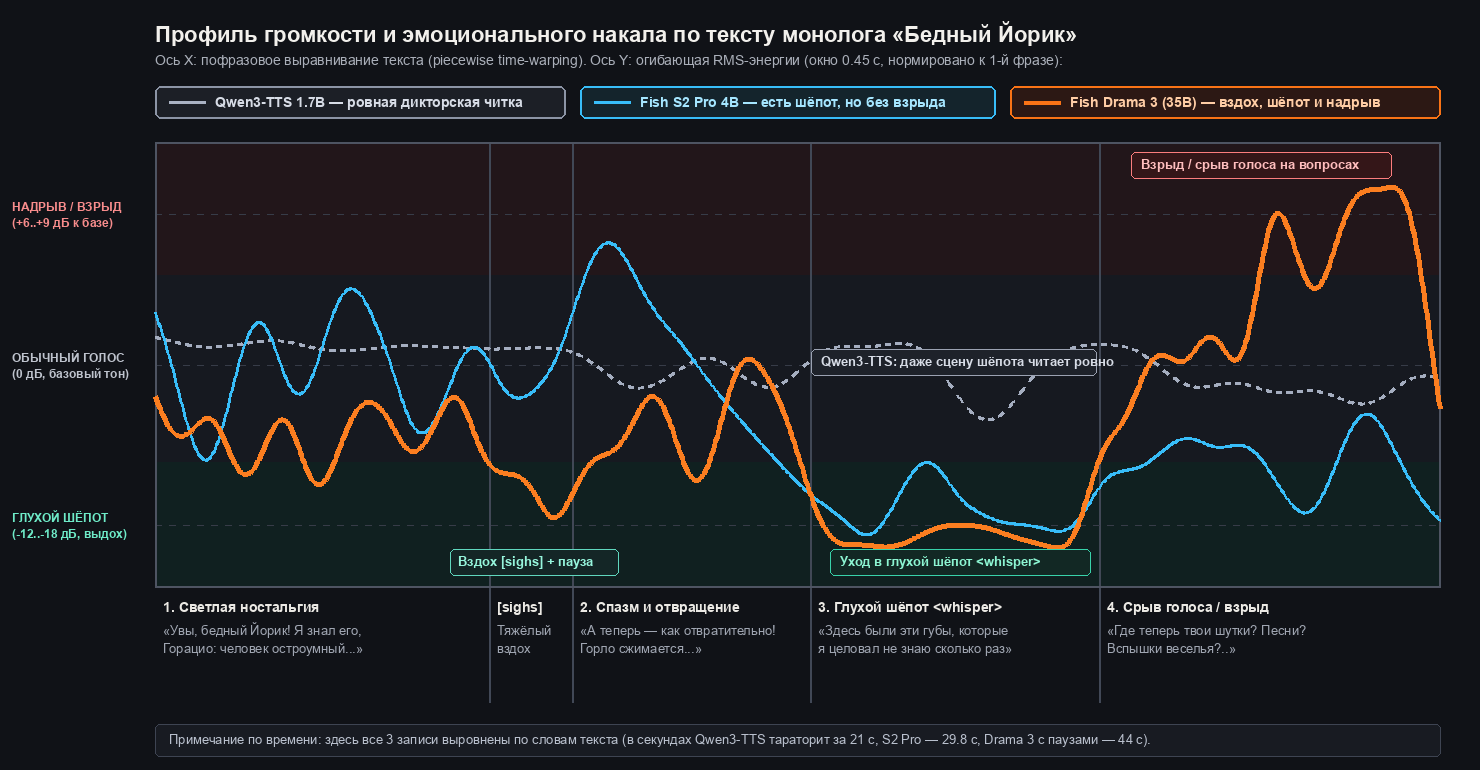
Для ровной дикторской начитки локальных TTS-моделей сегодня хватает с запасом: подаёшь на вход чистый образец голоса, расставляешь ударения — и получаешь разборчивую озвучку для лекции, технической заметки или видеоинструкции. Сложности начинаются, когда нужна не дикторская читка, а актёрская игра с широким эмоциональным диапазоном — чтобы внутри одного абзаца голос прошёл через горькую иронию, ком в горле, глухой шёпот на выдохе и резкий эмоциональный срыв. Компактные модели на 0,5B–1,7B параметров такие перепады сглаживают: нейросеть держит среднюю интонацию исходного образца и читает драматический монолог с тем же бодрым выражением, что и документацию к API. Ниже расскажу, через какие грабли я прошёл, пытаясь решить эту задачу локально — от ручной правки высоты голоса в фонетическом пакете Praat до подбора актёрских референсов — и как с этим справляется вышедшая в конце октября 2026 года модель Fish Audio Drama 3 (35B-A3B MoE) в сравнении с младшей версией S2 Pro (4B). Читать далее
Continue to Habr →You are being forwarded in 6s — stay on this page