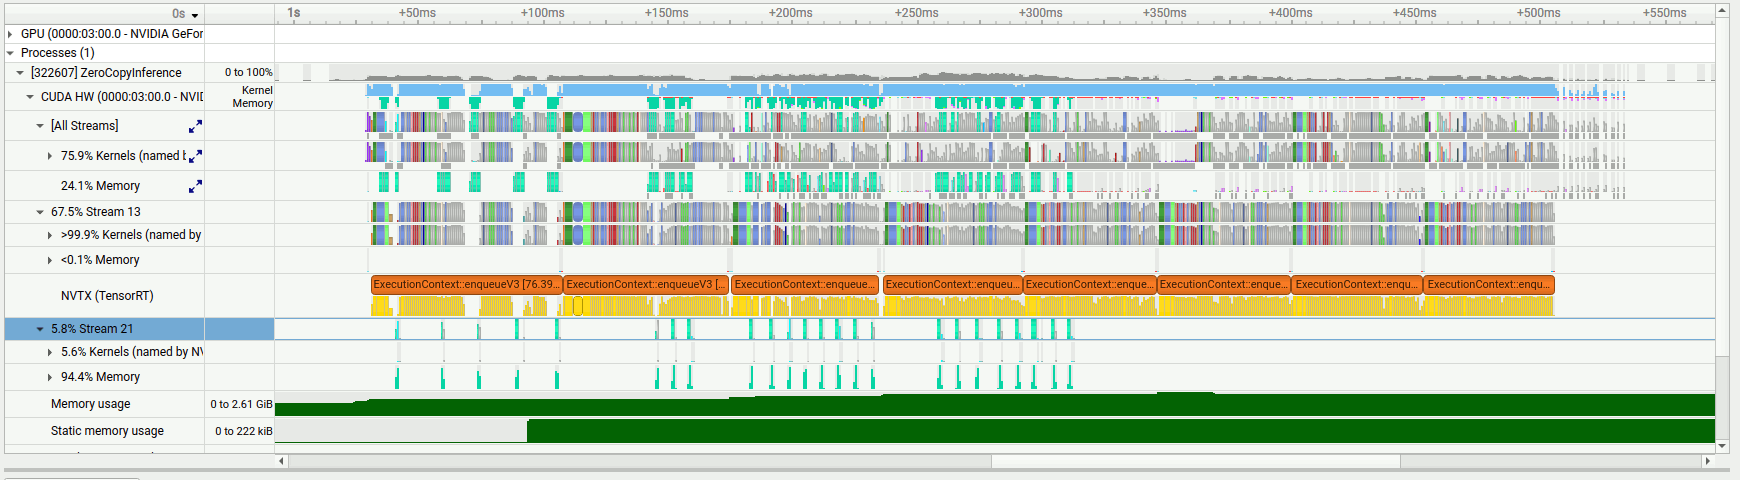
Когда современные нейросетевые модели с INT8-квантованием начинают выполняться за единицы миллисекунд, «узкое место» системы смещается с чистой вычислительной мощности на инфраструктуру вычислительного конвейера и операции ввода-вывода. При использовании дискретных графических процессоров многократная передача видеокадров высокого разрешения и промежуточных данных, таких как, например, bounding boxes (для случая object detection), по шине PCIe способна существенно снизить общую пропускную способность. Архитектура Zero-Host-Copy заключается в том, чтобы начиная с чтения с диска перед декодированием и заканчивая записью на диск после финального кодирования, файлы кадров оставались в памяти GPU и обрабатывались только с помощью GPU, а копирования данных GPU -> CPU и обратно минимизировались. Если же говорить про Zero-Copy архитектуру, то под ней подразумевается передача блоков данных для обработки от одного этапа конвейера к другому исключительно по указателю без излишнего копирования данных. Впрочем, лишние копирования CPU-GPU — не единственный скрытый фактор, снижающий эффективность конвейера. Динамическое выделение памяти в процессе работы системы столь же пагубно сказывается на быстродействии в реальном времени. Это происходит в связи с тем, что вызов cudaMalloc влечет за собой неявную синхронизацию (implicit synchronization), заставляя CPU ждать GPU, что нарушает асинхронность конвейера. Для достижения максимальной частоты кадров (FPS) высокопроизводительная система должна строиться с учетом реализации трех фаз жизненного цикла: «фаза инициализации» (initialization phase), «фаза подготовки» (warm-up phase) и «фаза активной работы» (hot phase). На этапе инициализации приложение заранее выделяет необходимые пулы памяти, буферы и очереди с начальными параметрами вложенности (глубины). В процессе фазы подготовки система запускает полную очередь обработки, где возможно срабатывание механизмов выделения дополнительных буферов в соответствии с реальной работой. Как только конвейер переходит в фазу активной работы после прогона нескольких начальных кадров, динамическое выделение памяти должно быть полностью исключено. Такая архитектура не допускает вызовов cudaMalloc или new во время выполнения, полагаясь исключительно на повторное использование уже выделенных блоков памяти для поддержания стабильной частоты (FPS). В статье - реализация bare-metal конвейера без DeepStream: обработка видео с YOLOv8m (1024x1024-INT8) на ~165–215 FPS (RTX 3060 Ti) и ~38 FPS (Jetson Orin Nano Super). Читать далее
Continue to Habr →You are being forwarded in 6s — stay on this page