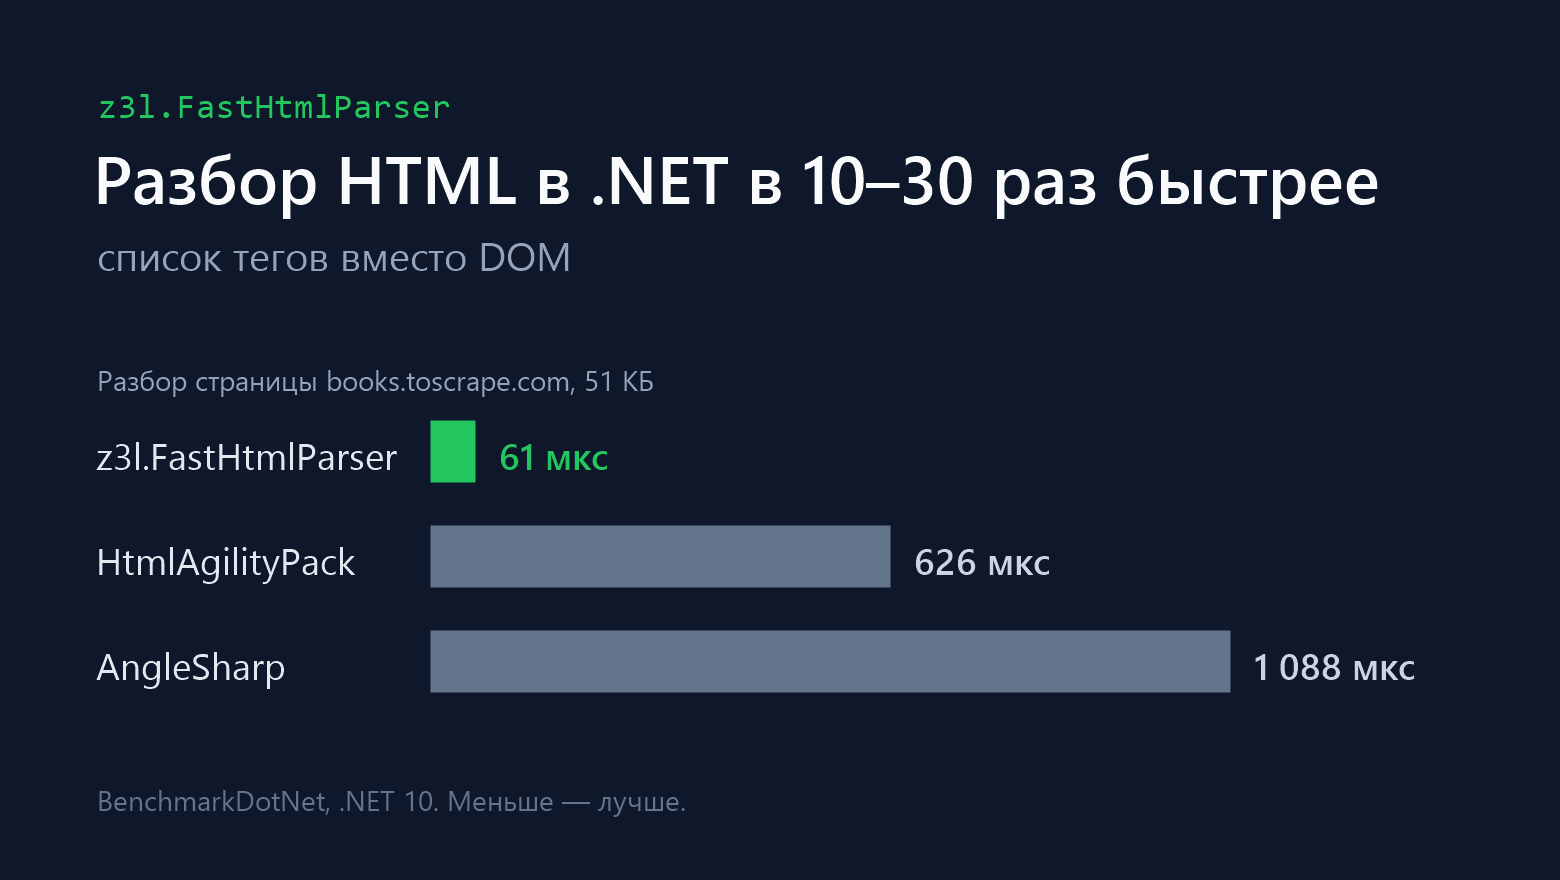
Много лет занимаюсь парсингом: каталоги, цены, карточки товаров, объявления. Всё это время из проекта в проект кочевал мой самописный HTML-парсер. Он стабильно работал на миллионах страниц, но показывать его наружу было как-то неловко: тесты покрывали только нужные мне сайты, комментарии были на двух языках вперемешку, документации не было вовсе. Появилась иишка и доделала то что мне было лень и я выложил nuget: z3l.FastHtmlParser Ниже разбираемся, почему стандартные библиотеки на таких задачах впустую тратят процессорное время, как уйти от аллокаций DOM и где проходят границы применимости легковесного подхода. Почему DOM избыточен для парсинга Парсинг — это работа с объёмами. Когда через сервис проходят миллионы страниц в сутки, разбор разметки оказывается самым горячим циклом, а затраты на серверы растут пропорционально. Лидеры рынка в .NET — HtmlAgilityPack и AngleSharp — отличные библиотеки, но решают более общую задачу браузерного уровня. Они строят полноценный DOM: создают отдельный объект на каждый узел, достраивают неявные <html>, <head>, <tbody>, держат дерево для мутаций и обхода CSS-селекторами. Для извлечения данных почти ничего из этого не нужно. Задача простая: найти элемент, забрать текст или значение атрибута и перейти к следующей странице. Всё остальное превращается в лишнюю работу процессора и сборщика мусора (GC). Отсюда простая идея: не строить то, что не будет использовано. Документ можно представить как просто список кусков исходной строки. Бенчмарки Тестовый стенд: BenchmarkDotNet 0.15.8, .NET 10, Intel Xeon E-2236, Windows Server 2025. Страницы настоящие, сохранённые с books.toscrape.com , quotes.toscrape.com и webscraper.io/test-sites . Версии библиотек: AngleSharp 1.10.0, HtmlAgilityPack 1.13.1. Читать далее
Continue to Habr →You are being forwarded in 6s — stay on this page