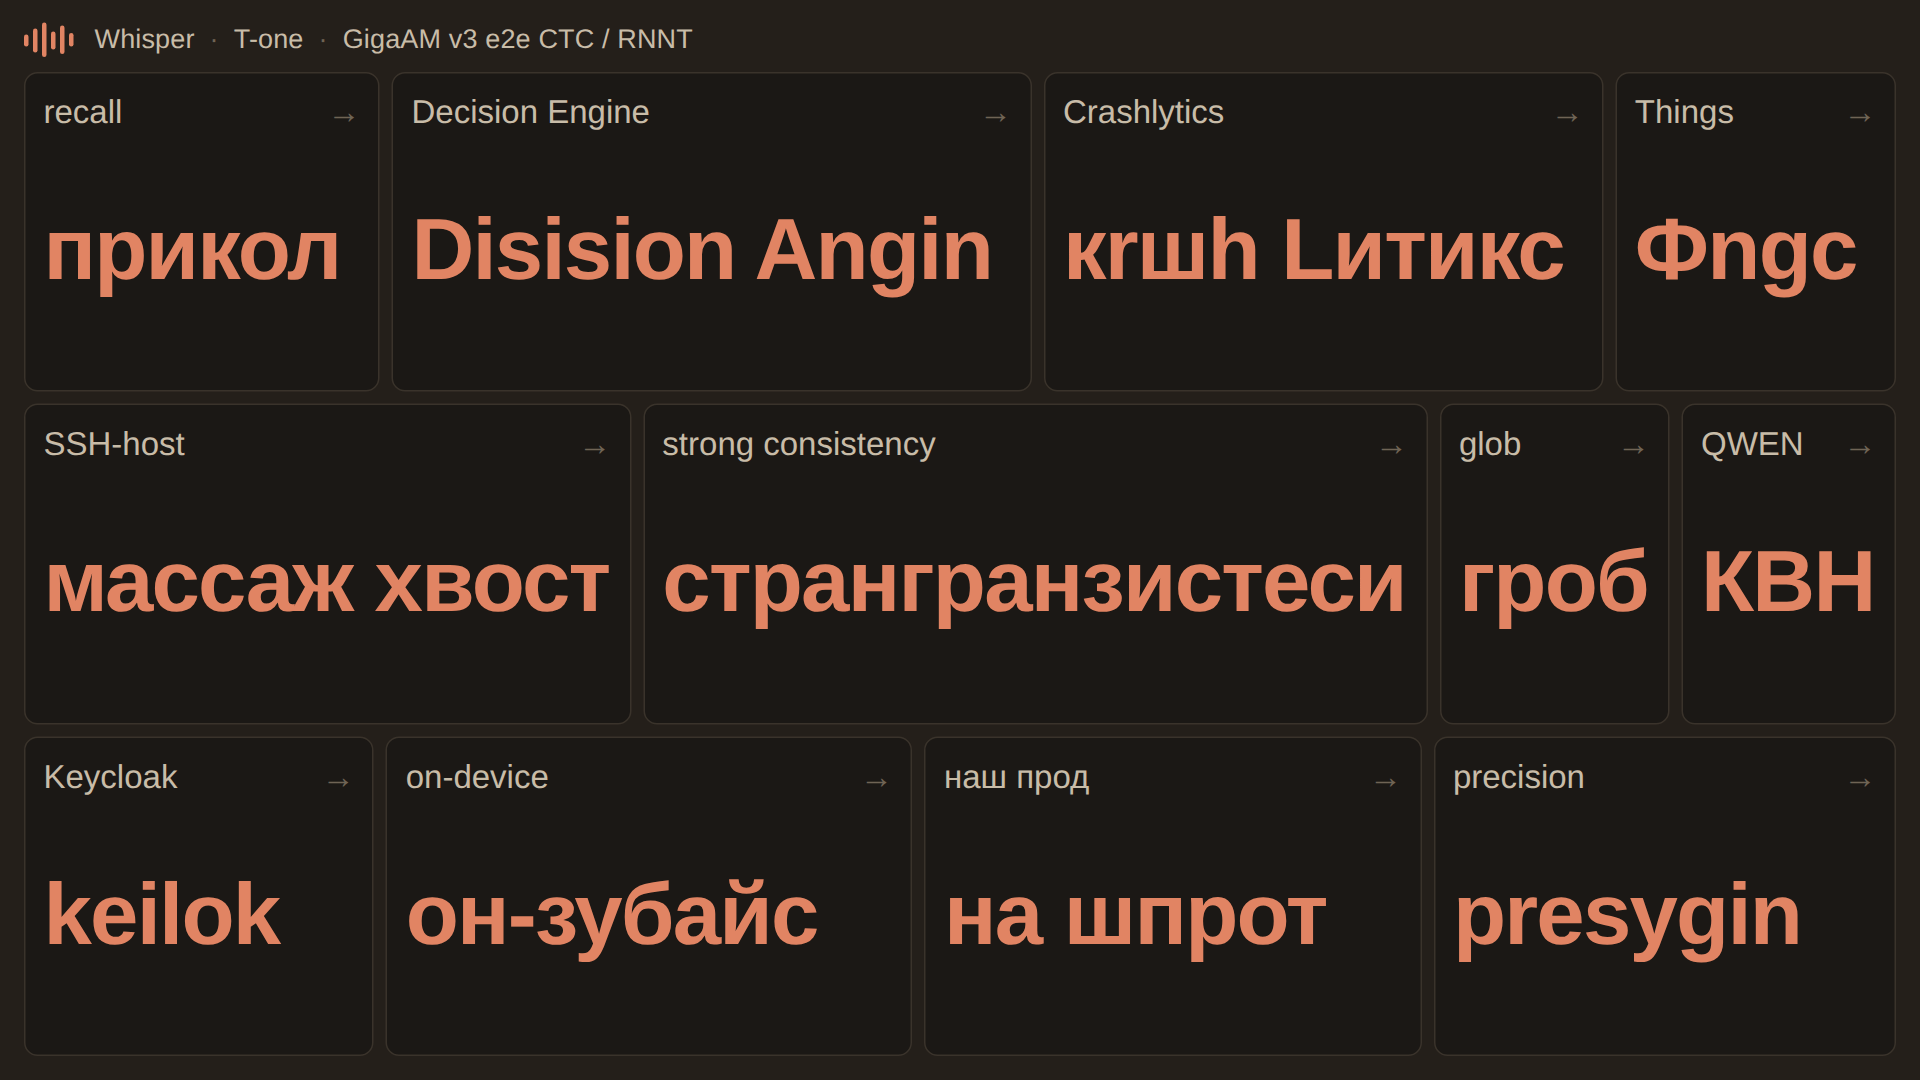
В этой статье я расскажу о том, как бенчмарк распознавания речи при AI-разработке голосом. Поговорим про сам замер, фабрики софта, постановку задач, особенности речи и датасет, посмотри на циферки и разберемся почему классический WER — очень коварная метрика, особенно в разработке. Ну что, лонг-тапнем на диплинк и деплоим на шпрот? Читать далее
Continue to Habr →You are being forwarded in 6s — stay on this page