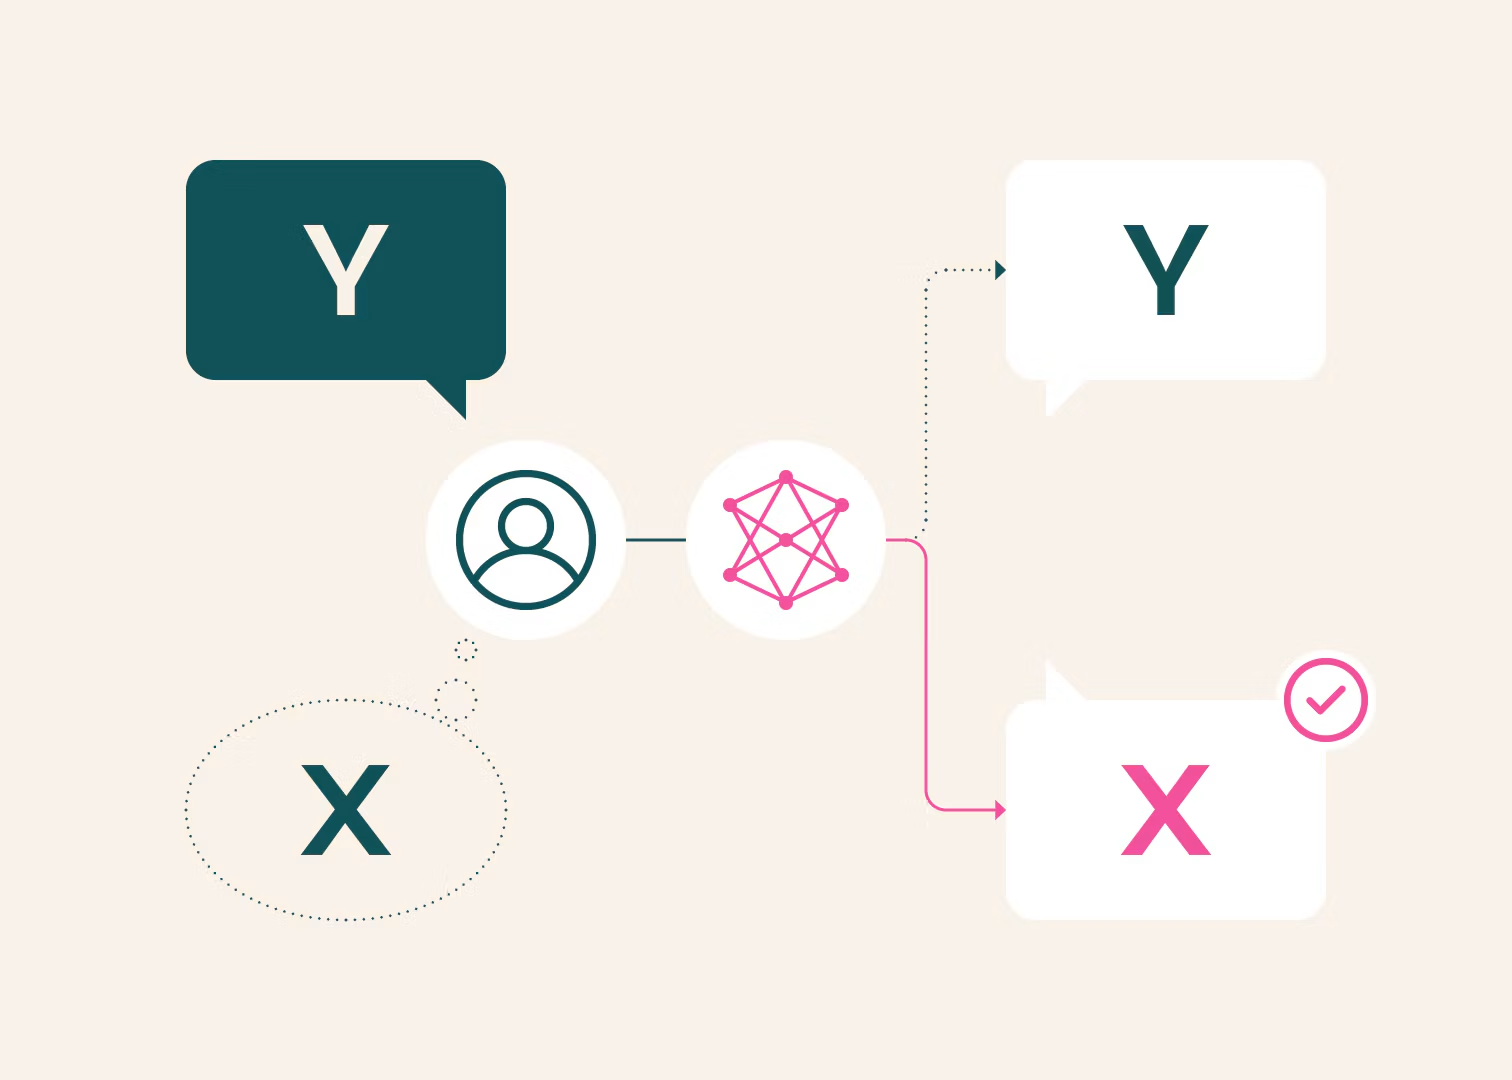
13 ноября 2026 года исследователи Allen Institute for AI (Ai2) представили XYBench , бенчмарк для проверки способности языковых моделей распознавать подобные ситуации. В него вошло 8 115 вопросов из программирования, технической поддержки и повседневных задач. Авторы протестировали Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B и DeepSeek-V4 Pro. Результаты выявили Читать далее
Continue to Habr →You are being forwarded in 6s — stay on this page