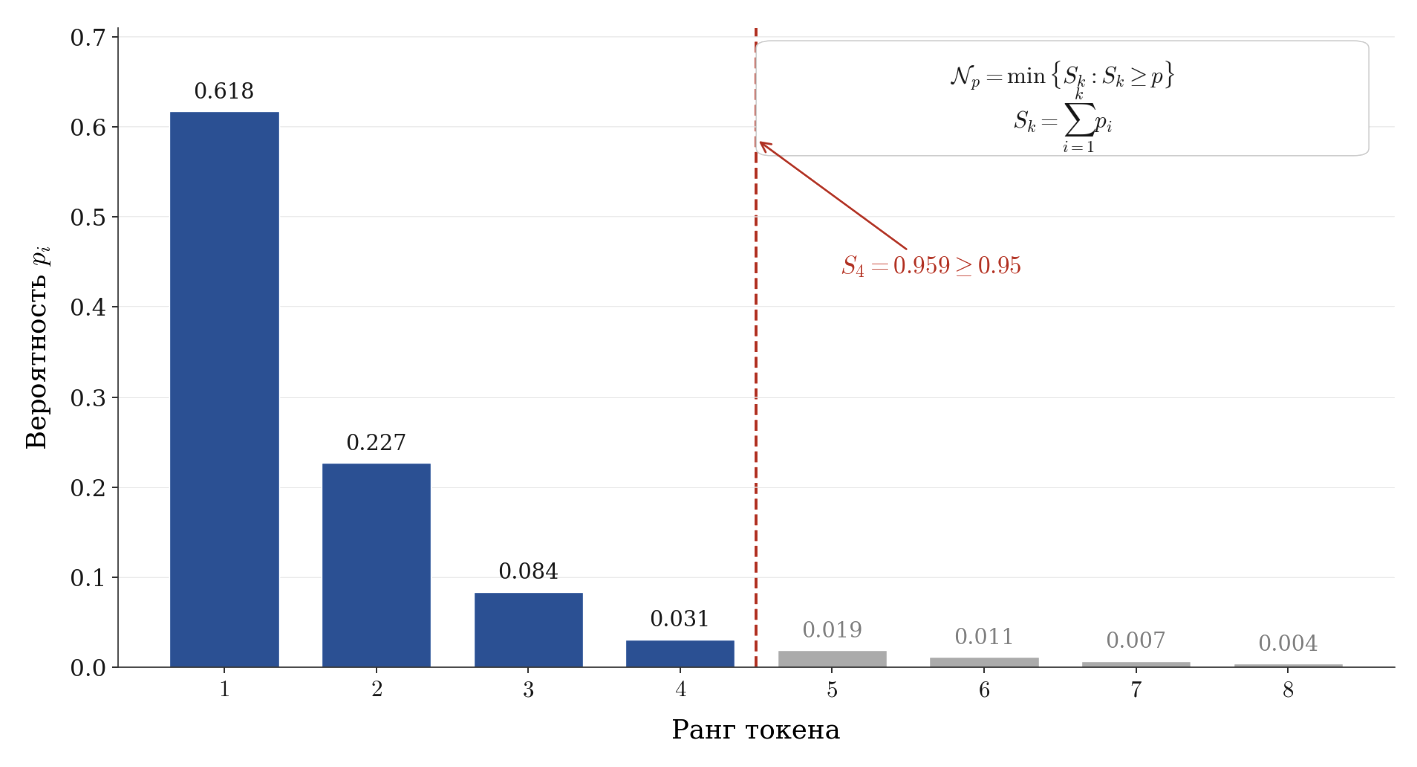
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг, квантизация, параллелизм. Эти компоненты формируют «скелет» системы и задают её предельные характеристики. Однако за пределами этого фокуса нередко остаётся слой, определяющий не скорость, а качество. Это параметры семплирования - правила выбора следующего токена из распределения логитов на каждом шаге декодирования. Читать далее
Continue to Habr →You are being forwarded in 6s — stay on this page