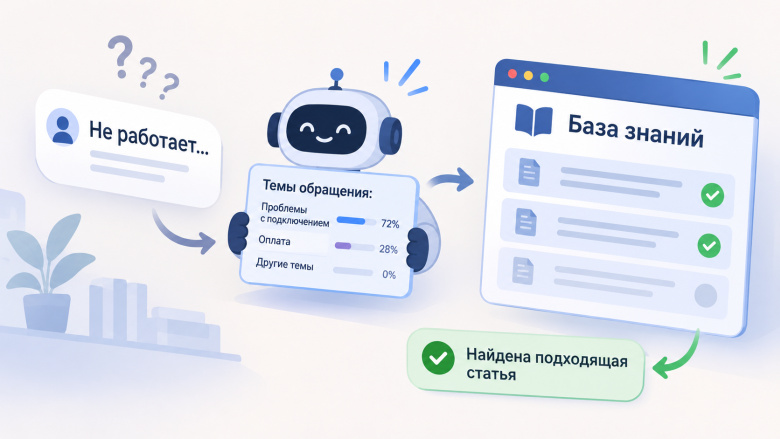
Автоматизировать поддержку хотят все. Большая часть вопросов пользователей повторяется, и так и хочется завернуть ответы на них в какой-нибудь алгоритм. Подходов много, но один из самых распространённых — векторный поиск: мы пытаемся понять, о чём пишет пользователь, находим в базе знаний семантически близкие статьи и просим LLM составить ответ на их основе. В презентации всё выглядит шикарно. Бот понимает вопрос, находит нужные материалы, формулирует ответ. Остаётся немного настроить — и можно отпускать сотрудников заниматься чем-нибудь более интересным. Но довольно быстро выясняется, что пользователи упорно не хотят действовать по алгоритму. Формулируют вопросы как придётся, опускают важные детали, ограничиваются коротким «не работает» или «помогите». Для векторного поиска такие сообщения создают проблему: в них слишком мало информации, чтобы уверенно определить смысл запроса. В результате подбор статей становится почти случайным: в выдачу попадают статьи, которые лишь условно похожи на обращение. Бывает и хуже: нужной статьи в базе вообще нет. Тогда LLM пытается собрать ответ из того, что нашлось по смежным темам. Получается связный текст, который может иметь довольно отдалённое отношение к проблеме пользователя. Модель, в общем, старается, но исходных данных ей никто не подвёз. В этой статье расскажу, как я решил подойти к обеим проблемам одновременно: изменить способ сопоставления обращений и статей, а затем использовать ту же тематическую разметку, чтобы находить пробелы в базе знаний и готовить черновики новых материалов. Читать далее
Continue to Habr →You are being forwarded in 6s — stay on this page